Eine statistische Auswertung mit Excel führen Sie in sechs Schritten durch: Sie legen die Daten als Tabelle an, aktivieren das Add-In „Analyse-Funktionen“, berechnen Kennwerte wie Mittelwert und Standardabweichung, erstellen Häufigkeiten und Diagramme und testen Ihre Hypothesen mit t-Test, Korrelation, Regression oder ANOVA. Für Bachelorarbeiten mit diesen Verfahren reicht Excel aus. Nichtparametrische Tests, Voraussetzungstests und Post-hoc-Tests fehlen in Excel, dafür brauchen Sie JASP, SPSS oder R.
Inhaltsverzeichnis
- Wann reicht Excel für die statistische Auswertung?
- Das Beispiel: Lernzeit und Klausurergebnis
- Schritt 1: Daten richtig in Excel anlegen
- Schritt 2: Analyse-Funktionen aktivieren
- Schritt 3: Deskriptive Statistik berechnen
- Schritt 4: Häufigkeiten auszählen
- Schritt 5: Diagramme erstellen
- Schritt 6: Hypothesen testen
- Ergebnisse berichten: Beispiel nach APA
- Grenzen von Excel bei der statistischen Auswertung
- Häufige Fehler bei der Auswertung mit Excel
- Excel-Funktionen für die Statistik: Übersicht
- Unterstützung bei Ihrer Excel-Auswertung
- Häufige Fragen zur statistischen Auswertung mit Excel
- Quellen
Wann reicht Excel für die statistische Auswertung?
Excel deckt die beschreibende Statistik und die gängigen parametrischen Tests ab. Prüfen Sie vor dem Start, ob Ihre geplanten Verfahren dabei sind:
| Verfahren | In Excel möglich? | Weg in Excel |
|---|---|---|
| Mittelwert, Median, Standardabweichung, Quartile | ja | Funktionen oder Add-In |
| Häufigkeiten, Kreuztabellen | ja | ZÄHLENWENN, PivotTable |
| Histogramm, Boxplot, Streudiagramm | ja | Diagramme → Statistik |
| t-Test (unabhängig, abhängig) | ja | T.TEST oder Add-In |
| Korrelation nach Pearson | ja | KORREL oder Add-In |
| Korrelation nach Spearman | mit Umweg | Ränge bilden, dann KORREL |
| Lineare Regression (einfach und multipel) | ja | Add-In „Regression“ |
| Einfaktorielle ANOVA | ja | Add-In, aber ohne Post-hoc-Test |
| Chi-Quadrat-Test | mit Umweg | erwartete Werte selbst berechnen, dann CHIQU.TEST |
| Cronbachs Alpha | mit Umweg | per Formel aus Varianzen |
| Shapiro-Wilk, Levene-Test | nein | JASP, SPSS, R |
| Mann-Whitney-U, Kruskal-Wallis, Wilcoxon | nein | JASP, SPSS, R |
| Logistische Regression, Faktorenanalyse, Mehrebenenmodelle | nein | SPSS, R |
Brauchen Sie ein Verfahren aus den unteren Zeilen, werten Sie besser gleich in einem Statistikprogramm aus. JASP ist kostenlos und öffnet Daten, die Sie in Excel als CSV-Datei speichern. Welches Verfahren zu Ihrer Fragestellung passt, klärt unsere Entscheidungshilfe: Welcher statistische Test?
Das Beispiel: Lernzeit und Klausurergebnis
Alle Schritte in diesem Beitrag rechnen wir an einem fiktiven Datensatz durch. 20 Studierende haben angegeben, wie viele Stunden pro Woche sie gelernt haben, und ihre Klausurpunkte (von 100) genannt. Zehn haben eine Präsenzveranstaltung besucht, zehn ein Online-Format.
Fragestellungen:
- Unterscheiden sich die Klausurpunkte zwischen Präsenz- und Online-Gruppe?
- Hängen Lernstunden und Klausurpunkte zusammen?
Datensatz (Spalte A bis D, Zeile 1 = Variablennamen, Daten in Zeile 2 bis 21):
| ID | Gruppe | Lernstunden | Punkte |
|---|---|---|---|
| 1 | Präsenz | 6 | 58 |
| 2 | Präsenz | 8 | 74 |
| 3 | Präsenz | 5 | 62 |
| 4 | Präsenz | 9 | 70 |
| 5 | Präsenz | 7 | 55 |
| 6 | Präsenz | 10 | 81 |
| 7 | Präsenz | 4 | 60 |
| 8 | Präsenz | 8 | 66 |
| 9 | Präsenz | 6 | 72 |
| 10 | Präsenz | 9 | 77 |
| 11 | Online | 3 | 52 |
| 12 | Online | 5 | 48 |
| 13 | Online | 7 | 66 |
| 14 | Online | 4 | 57 |
| 15 | Online | 6 | 50 |
| 16 | Online | 2 | 44 |
| 17 | Online | 5 | 63 |
| 18 | Online | 8 | 61 |
| 19 | Online | 4 | 45 |
| 20 | Online | 6 | 59 |
Übertragen Sie die Tabelle in Excel und rechnen Sie mit. Alle Ergebnisse unten können Sie so prüfen.
Schritt 1: Daten richtig in Excel anlegen
Die meisten Fehler in Excel-Auswertungen entstehen bei der Dateneingabe. Halten Sie sich an diese Regeln:
- Eine Zeile pro Person, eine Spalte pro Variable.
- Zeile 1 enthält die Variablennamen, kurz und ohne Leerzeichen:
Lernstundenstatt Wie viele Stunden lernen Sie?. - Keine verbundenen Zellen, Leerzeilen oder Zwischensummen im Datenbereich. PivotTables und das Add-In brechen sonst ab oder rechnen falsch.
- Zahlen als Zahlen: Kodieren Sie Antworten numerisch, etwa 1 = trifft überhaupt nicht zu bis 5 = trifft voll zu. Text wie „stimme zu“ kann Excel nicht mitteln.
- Fehlende Werte leer lassen.
MITTELWERTundSTABW.Süberspringen leere Zellen. Eine 0 oder −9 würde Excel als echten Wert mitrechnen. - Daten als Tabelle formatieren (Strg + T). Formeln und Diagramme wachsen dann mit, wenn Sie Fälle ergänzen.
Daten aus einem Umfrage-Tool importieren: Exportieren Sie aus SoSci Survey, LimeSurvey oder Google Forms als CSV oder direkt als Excel-Datei. Eine CSV-Datei öffnen Sie über Daten → Aus Text/CSV. Dort stellen Sie Trennzeichen und Dateiursprung ein. Prüfen Sie danach die Dezimalzahlen: Die deutsche Excel-Version erwartet ein Komma. Steht im Export ein Punkt, liest Excel „3.5“ als Text oder als Datum. Wie Sie einen Fragebogen so aufbauen, dass der Export später passt, erklärt unser Beitrag Fragebogen erstellen.
Schritt 2: Analyse-Funktionen aktivieren
Das Add-In „Analyse-Funktionen“ gehört zu Excel, ist aber ausgeschaltet. Es liefert t-Tests, ANOVA, Regression, Korrelationsmatrix, Histogramm und eine Tabelle mit allen deskriptiven Kennwerten.
Windows:
- Datei → Optionen → Add-Ins
- Unten bei „Verwalten“ „Excel-Add-Ins“ wählen und auf „Los…“ klicken
- Haken bei „Analyse-Funktionen“ setzen, mit OK bestätigen
Mac: Extras → Excel-Add-Ins → Haken bei „Analyse-Funktionen“.
Danach finden Sie rechts im Menüband unter Daten die Schaltfläche Datenanalyse. In Excel für das Web gibt es das Add-In nicht. Arbeiten Sie dort mit den Funktionen aus Schritt 3 und 6.
Die Schaltfläche Daten analysieren auf der Registerkarte Start ist eine andere Funktion. Sie schlägt automatisch Diagramme und PivotTables vor. Für eine erste Übersicht hilft sie, für Hypothesentests nicht.
Schritt 3: Deskriptive Statistik berechnen
Beschreiben Sie Ihre Stichprobe, bevor Sie testen. Für die Variable Punkte (Spalte D) lauten Formeln und Ergebnisse:
| Kennwert | Formel | Ergebnis |
|---|---|---|
| Anzahl | =ANZAHL(D2:D21) | 20 |
| Mittelwert | =MITTELWERT(D2:D21) | 61,0 |
| Median | =MEDIAN(D2:D21) | 60,5 |
| Standardabweichung | =STABW.S(D2:D21) | 10,42 |
| Varianz | =VAR.S(D2:D21) | 108,63 |
| Minimum / Maximum | =MIN(D2:D21) / =MAX(D2:D21) | 44 / 81 |
| 1. und 3. Quartil | =QUARTILE.INKL(D2:D21;1) / ;3) | 54,25 / 67,0 |
| Modus (Lernstunden) | =MODUS.EINF(C2:C21) | 6 |
STABW.S oder STABW.N? Für eine Stichprobe nutzen Sie STABW.S. STABW.N teilt durch n statt durch n − 1 und gilt nur, wenn Sie die gesamte Grundgesamtheit erfasst haben. In Abschlussarbeiten ist STABW.S fast immer richtig. Gleiches gilt für VAR.S und VAR.P.
Kennwerte je Gruppe: Den Mittelwert einer Gruppe berechnen Sie mit =MITTELWERTWENN(B2:B21;"Präsenz";D2:D21). Für die Standardabweichung je Gruppe gibt es keine WENN-Variante. In Microsoft 365 und Excel 2021 nutzen Sie =STABW.S(FILTER(D2:D21;B2:B21="Präsenz")). In älteren Versionen sortieren Sie nach Gruppe und markieren den Bereich.
| Gruppe | n | Mittelwert | Standardabweichung |
|---|---|---|---|
| Präsenz | 10 | 67,5 | 8,67 |
| Online | 10 | 54,5 | 7,76 |
Alle Kennwerte auf einmal: Daten → Datenanalyse → Populationskenngrößen. Eingabebereich D1:D21 markieren, „Beschriftungen in erster Zeile“ und „Statistische Kenngrößen“ anhaken. Excel gibt Mittelwert, Standardfehler, Median, Modus, Standardabweichung, Varianz, Kurtosis, Schiefe, Minimum, Maximum und Anzahl aus.
Schritt 4: Häufigkeiten auszählen
Wie oft kommt ein Wert vor? =ZÄHLENWENN(C2:C21;6) zählt, wie viele Personen 6 Stunden gelernt haben: 4. Mit mehreren Bedingungen nutzen Sie ZÄHLENWENNS, etwa =ZÄHLENWENNS(B2:B21;"Online";C2:C21;">=6") für Online-Teilnehmer mit mindestens 6 Stunden: 4.
Häufigkeiten in Klassen: Tragen Sie die Obergrenzen der Klassen in F2:F5 ein (49, 59, 69, 79) und schreiben Sie in G2 =HÄUFIGKEIT(D2:D21;F2:F5). In Microsoft 365 füllt Excel die Ergebnisse automatisch nach unten, in älteren Versionen markieren Sie G2:G6 und bestätigen mit Strg + Umschalt + Enter.
| Punkte | Anzahl | Prozent |
|---|---|---|
| bis 49 | 3 | 15 % |
| 50 bis 59 | 6 | 30 % |
| 60 bis 69 | 6 | 30 % |
| 70 bis 79 | 4 | 20 % |
| 80 und mehr | 1 | 5 % |
PivotTable: Für kategoriale Variablen und Kreuztabellen ist die PivotTable am schnellsten. Daten markieren → Einfügen → PivotTable → Variable „Gruppe“ in „Zeilen“ und noch einmal in „Werte“ ziehen. Excel zeigt dann „Anzahl von Gruppe“. Über Wertfeldeinstellungen → Werte anzeigen als → „% des Gesamtergebnisses“ erhalten Sie Prozente. Eine zweite Variable in „Spalten“ ergibt eine Kreuztabelle.
Schritt 5: Diagramme erstellen
| Diagramm | Wofür | Weg in Excel |
|---|---|---|
| Histogramm | Verteilung einer metrischen Variable | Einfügen → Statistikdiagramm → Histogramm |
| Boxplot | Median, Quartile und Ausreißer, Gruppen vergleichen | Einfügen → Statistikdiagramm → Kastengrafik |
| Streudiagramm | Zusammenhang zweier metrischer Variablen | Einfügen → Punkt (XY) |
| Säulendiagramm | Häufigkeiten oder Mittelwerte je Gruppe | Einfügen → Säule |
| Gestapeltes Balkendiagramm (100 %) | Likert-Items vergleichen | Einfügen → Balken → 100 % gestapelt |
Für Abschlussarbeiten gilt: Achsen beschriften, Einheit angeben, Titel und Legende sachlich halten, auf 3D-Effekte verzichten. Zeigen Sie Mittelwerte im Säulendiagramm, ergänzen Sie Fehlerbalken (Diagrammelemente → Fehlerindikatoren → Benutzerdefiniert) mit Standardabweichung oder Standardfehler und nennen Sie in der Beschriftung, welchen Wert Sie zeigen.
Schritt 6: Hypothesen testen
t-Test in Excel
Der t-Test prüft, ob sich zwei Mittelwerte unterscheiden. Für die erste Fragestellung (Präsenz gegen Online) schreiben Sie:
=T.TEST(D2:D11;D12:D21;2;3) → 0,0024
Das Ergebnis ist der p-Wert. Die beiden letzten Argumente legen den Test fest:
| Argument | Wert | Bedeutung |
|---|---|---|
| Seiten | 1 | einseitig, nur bei gerichteter Hypothese mit Begründung |
| 2 | zweiseitig, Standard | |
| Typ | 1 | abhängige Stichproben (dieselben Personen zweimal gemessen) |
| 2 | unabhängige Stichproben, gleiche Varianzen (Student) | |
| 3 | unabhängige Stichproben, ungleiche Varianzen (Welch) |
Wählen Sie für unabhängige Gruppen Typ 3. Der Welch-Test bleibt auch bei ungleichen Varianzen korrekt und verliert bei gleichen Varianzen kaum Teststärke (Delacre et al., 2017). Den Levene-Test, mit dem SPSS die Varianzgleichheit prüft, bietet Excel nicht an.
t-Wert und Freiheitsgrade: T.TEST liefert nur den p-Wert. Für den Bericht brauchen Sie auch t und die Freiheitsgrade. Diese gibt das Add-In aus: Daten → Datenanalyse → „Zweistichproben t-Test: Unterschiedliche Varianzen“. Bereich Variable 1 = D2:D11, Variable 2 = D12:D21, Hypothetische Differenz 0. Ergebnis: t = 3,53, p (zweiseitig) = 0,0024.
Effektstärke Cohens d: Excel berechnet keine Effektstärke. Mit dieser Formel erhalten Sie d aus der gepoolten Standardabweichung:
=(MITTELWERT(D2:D11)-MITTELWERT(D12:D21))/WURZEL(((ANZAHL(D2:D11)-1)*VAR.S(D2:D11)+(ANZAHL(D12:D21)-1)*VAR.S(D12:D21))/(ANZAHL(D2:D11)+ANZAHL(D12:D21)-2))Ergebnis: d = 1,58. Nach Cohen (1988) gilt d ab 0,2 als kleiner, ab 0,5 als mittlerer und ab 0,8 als großer Effekt.
Wann der t-Test passt und wie Sie ihn interpretieren, erklärt unser Beitrag t-Test mit Formel und Beispiel.
Korrelation und Regression in Excel
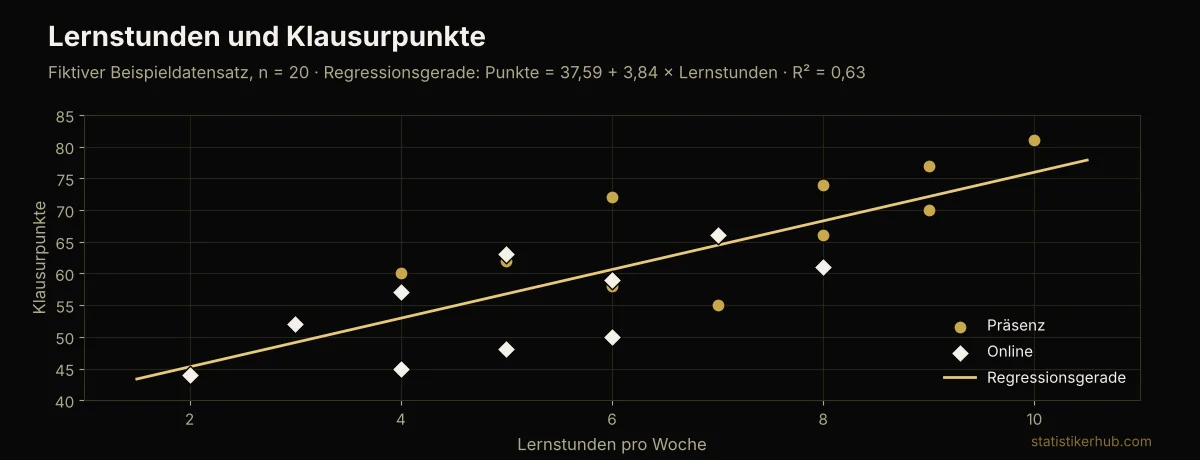
Für die zweite Fragestellung (Lernstunden und Punkte) berechnen Sie zuerst die Korrelation:
=KORREL(C2:C21;D2:D21) → r = 0,79
Den p-Wert der Korrelation gibt KORREL nicht aus. Sie erhalten ihn über die Regression unten oder mit =T.VERT.2S(ABS(r)*WURZEL(n-2)/WURZEL(1-r^2);n-2), wobei Sie für r die Zelle mit dem Korrelationskoeffizienten und für n die Fallzahl einsetzen. Im Beispiel ist p < 0,001.
Spearman-Korrelation: Bei ordinalen Daten oder Ausreißern bilden Sie zuerst Ränge mit =RANG.MITTELW(C2;C$2:C$21;1) für jede Zelle beider Variablen und korrelieren dann die Rangspalten mit KORREL. Im Beispiel ergibt das ρ = 0,75.
Lineare Regression: Daten → Datenanalyse → Regression. Y-Eingabebereich = D1:D21 (Punkte), X-Eingabebereich = C1:C21 (Lernstunden), „Beschriftungen“ anhaken. Für eine multiple Regression markieren Sie mehrere nebeneinanderliegende X-Spalten. Die Ausgabe enthält:
| Kennwert in der Ausgabe | Wert im Beispiel | Bedeutung |
|---|---|---|
| Bestimmtheitsmaß (R²) | 0,63 | 63 % der Unterschiede in den Punkten gehen mit den Lernstunden einher |
| F und „Signifikanz F“ | F(1, 18) = 30,2, p < 0,001 | Das Modell erklärt mehr als ein Modell ohne Prädiktor |
| Koeffizient Schnittpunkt | 37,59 | erwartete Punkte bei 0 Lernstunden |
| Koeffizient Lernstunden | 3,84 (SE = 0,70) | jede Stunde mehr geht mit 3,84 Punkten mehr einher |
| P-Wert Lernstunden | < 0,001 | Der Zusammenhang ist signifikant |
Die Regressionsgleichung lautet: Punkte = 37,59 + 3,84 × Lernstunden. Einzelwerte liefern auch die Funktionen =STEIGUNG(D2:D21;C2:C21), =ACHSENABSCHNITT(D2:D21;C2:C21) und =BESTIMMTHEITSMASS(D2:D21;C2:C21). Haken Sie im Dialog zusätzlich „Residuen“ und „Residuendiagramm“ an, um die Voraussetzungen grafisch zu prüfen. Mehr zu Modell und Voraussetzungen lesen Sie im Beitrag Regression einfach erklärt.
Eine Korrelation belegt keine Ursache. Ob mehr Lernen bessere Noten bewirkt oder motivierte Studierende beides zeigen, beantwortet diese Analyse nicht.
ANOVA in Excel
Für drei oder mehr Gruppen nutzen Sie die einfaktorielle Varianzanalyse: Daten → Datenanalyse → „Anova: Einfaktorielle Varianzanalyse“. Die Werte jeder Gruppe müssen dafür in einer eigenen Spalte stehen. Excel gibt F, p und „F krit“ aus.
Ist die ANOVA signifikant, wissen Sie nur, dass sich mindestens zwei Gruppen unterscheiden. Welche das sind, zeigt ein Post-hoc-Test wie Tukey oder Bonferroni, und den bietet Excel nicht an. Ein Ausweg sind paarweise t-Tests mit Bonferroni-Korrektur: Sie teilen das Signifikanzniveau durch die Zahl der Vergleiche, bei drei Vergleichen also 0,05 / 3 = 0,017. Zur Methode lesen Sie ANOVA einfach erklärt.
Chi-Quadrat-Test in Excel
Der Chi-Quadrat-Test prüft, ob zwei kategoriale Variablen zusammenhängen. Erstellen Sie zuerst mit der PivotTable eine Kreuztabelle der beobachteten Häufigkeiten. Daneben berechnen Sie für jede Zelle die erwartete Häufigkeit: Zeilensumme × Spaltensumme / Gesamtzahl. Danach liefert =CHIQU.TEST(beobachtet;erwartet) den p-Wert. Den Chi-Quadrat-Wert selbst gibt die Funktion nicht aus. Sie erhalten ihn mit =CHIQU.INV.RE(p;Freiheitsgrade), Freiheitsgrade = (Zeilen − 1) × (Spalten − 1). Ist eine erwartete Häufigkeit kleiner als 5, ist der Test unzuverlässig. SPSS und R bieten dann den exakten Test nach Fisher an.
Ergebnisse berichten: Beispiel nach APA
So berichten Sie die Ergebnisse des Beispiels im Ergebnisteil:
Die Präsenzgruppe erreichte mehr Klausurpunkte (M = 67,5, SD = 8,67) als die Online-Gruppe (M = 54,5, SD = 7,76). Ein Welch-t-Test zeigte einen signifikanten Unterschied, t(17,8) = 3,53, p = .002, d = 1,58. Die Lernstunden korrelierten positiv mit den Klausurpunkten, r = .79, p < .001. In einer linearen Regression sagten die Lernstunden die Klausurpunkte vorher, b = 3,84, SE = 0,70, p < .001, R² = .63.
Hinweise:
- p-Werte ohne führende Null (p = .002), da p nicht größer als 1 werden kann. Gleiches gilt für r und R².
- Mittelwerte und Standardabweichungen mit einer oder zwei Nachkommastellen, einheitlich im ganzen Text.
- Excel zeigt sehr kleine p-Werte als 3,2E-05. Berichten Sie dann p < .001.
- Die Freiheitsgrade des Welch-Tests sind meist keine ganze Zahl. Berechnen Sie sie mit der Welch-Satterthwaite-Formel oder übernehmen Sie den Wert aus JASP, falls das Add-In ihn gerundet ausgibt.
Grenzen von Excel bei der statistischen Auswertung
| Grenze | Folge für Ihre Arbeit | Alternative |
|---|---|---|
| Keine Voraussetzungstests (Shapiro-Wilk, Levene) | Sie können Normalverteilung und Varianzgleichheit nur grafisch prüfen | JASP, SPSS, R |
| Keine nichtparametrischen Tests | Bei ordinalen Daten oder kleinen, schiefen Stichproben fehlt der passende Test | JASP, SPSS, R |
| Keine Post-hoc-Tests nach der ANOVA | Sie wissen nicht, welche Gruppen sich unterscheiden | JASP, SPSS, R |
| Keine Effektstärken | Sie rechnen Cohens d und η² per Formel | JASP berechnet sie automatisch |
| Keine Dokumentation der Klicks | Gutachter können die Analyse schwer nachvollziehen | SPSS-Syntax, R-Skript |
| Add-In-Ausgabe aktualisiert sich nicht | Ändern Sie Daten, müssen Sie die Analyse neu starten | Formeln statt Add-In |
| 1.048.576 Zeilen pro Tabellenblatt | Große Datensätze werden langsam | R, Python |
Ein häufiger Weg in Abschlussarbeiten: Daten in Excel erfassen und bereinigen, beschreibende Statistik und Diagramme in Excel, Tests in JASP oder SPSS. Für JASP speichern Sie die Tabelle über Datei → Speichern unter als CSV-Datei. Einen Einstieg in SPSS bietet der Beitrag Fragebogen in SPSS auswerten.
Häufige Fehler bei der Auswertung mit Excel
- STABW.N statt STABW.S: Die Standardabweichung fällt zu klein aus.
- Fehlende Werte als 0 eingetragen: Mittelwert und Standardabweichung stimmen nicht mehr.
- Falscher Typ im T.TEST: Typ 1 für unabhängige Gruppen rechnet einen Test für Messwiederholung.
- Einseitig getestet ohne Begründung: Der p-Wert halbiert sich, Gutachter werten das als Fehler.
- Add-In-Ergebnis nach Datenänderung nicht neu berechnet: Die Tabelle zeigt alte Werte.
- Bereiche verrutscht: Beim Kopieren einer Formel ändern sich die Bezüge. Setzen Sie Dollarzeichen (
$D$2:$D$21), wenn ein Bereich fest bleiben soll. - Likert-Items gemittelt, ohne die Skala zu prüfen: Bilden Sie einen Skalenwert erst, wenn Cronbachs Alpha passt. Die Schritte zeigt der Beitrag Likert-Skala auswerten, mit einem eigenen Abschnitt für Excel.
Excel-Funktionen für die Statistik: Übersicht
| Zweck | Funktion (deutsch) | Englischer Name |
|---|---|---|
| Mittelwert | MITTELWERT | AVERAGE |
| Mittelwert mit Bedingung | MITTELWERTWENN / MITTELWERTWENNS | AVERAGEIF / AVERAGEIFS |
| Median | MEDIAN | MEDIAN |
| Modus | MODUS.EINF | MODE.SNGL |
| Standardabweichung (Stichprobe) | STABW.S | STDEV.S |
| Varianz (Stichprobe) | VAR.S | VAR.S |
| Quartile | QUARTILE.INKL | QUARTILE.INC |
| Anzahl Zahlen / nicht leere Zellen | ANZAHL / ANZAHL2 | COUNT / COUNTA |
| Häufigkeit mit Bedingung | ZÄHLENWENN / ZÄHLENWENNS | COUNTIF / COUNTIFS |
| Häufigkeit in Klassen | HÄUFIGKEIT | FREQUENCY |
| Schiefe / Kurtosis | SCHIEFE / KURT | SKEW / KURT |
| Korrelation | KORREL | CORREL |
| Rang | RANG.MITTELW | RANK.AVG |
| Regression | STEIGUNG, ACHSENABSCHNITT, BESTIMMTHEITSMASS, RGP | SLOPE, INTERCEPT, RSQ, LINEST |
| t-Test | T.TEST | T.TEST |
| Chi-Quadrat-Test | CHIQU.TEST | CHISQ.TEST |
| Konfidenzintervall (halbe Breite) | KONFIDENZ.T | CONFIDENCE.T |
Die englischen Namen brauchen Sie, wenn Sie mit einer englischen Excel-Version arbeiten oder Anleitungen aus dem Internet übertragen. Die englische Version trennt Argumente mit Komma statt Semikolon.
Unterstützung bei Ihrer Excel-Auswertung
Unsere Statistik-Experten beraten Sie zur Wahl des Tests, zu den Grenzen von Excel und zur Interpretation Ihrer Ergebnisse, auch beim Wechsel zu JASP, SPSS oder R. Sie werten Ihre Daten selbst aus und klären mit uns die methodischen Fragen. Mehr dazu auf der Seite Statistik-Beratung.
Beratung anfragenHäufige Fragen zur statistischen Auswertung mit Excel
Reicht Excel für die statistische Auswertung einer Bachelorarbeit?
Ja, wenn Sie beschreibende Statistik, t-Tests, Korrelationen, lineare Regression oder eine einfaktorielle ANOVA brauchen. Für nichtparametrische Tests, Voraussetzungstests, Post-hoc-Tests oder logistische Regression reicht Excel nicht. Klären Sie mit Ihrem Betreuer, ob ein bestimmtes Programm vorgeschrieben ist.
Wie aktiviere ich die Datenanalyse in Excel?
Unter Windows: Datei → Optionen → Add-Ins → bei „Verwalten“ Excel-Add-Ins wählen → Los → Haken bei „Analyse-Funktionen“. Auf dem Mac: Extras → Excel-Add-Ins. Danach erscheint unter Daten die Schaltfläche „Datenanalyse“.
Wie kann ich in Excel ermitteln, wie oft ein Wert vorkommt?
Mit =ZÄHLENWENN(Bereich;Wert), etwa =ZÄHLENWENN(C2:C21;6). Für alle Werte einer Variable auf einmal nutzen Sie eine PivotTable mit der Variable in „Zeilen“ und „Werte“, für Klassen die Funktion HÄUFIGKEIT.
Welche Standardabweichung nehme ich in Excel, STABW.S oder STABW.N?
STABW.S für Stichproben, also in fast allen Abschlussarbeiten und Studien. STABW.N nur, wenn Ihre Daten die gesamte Grundgesamtheit umfassen, etwa alle Mitarbeiter eines Unternehmens.
Wie mache ich einen t-Test in Excel?
Mit =T.TEST(Gruppe1;Gruppe2;2;3) erhalten Sie den p-Wert eines zweiseitigen Welch-t-Tests für unabhängige Gruppen. Für t-Wert und Freiheitsgrade nutzen Sie Daten → Datenanalyse → „Zweistichproben t-Test: Unterschiedliche Varianzen“.
Kann Excel einen Mann-Whitney-U-Test oder Kruskal-Wallis-Test rechnen?
Nicht mit Bordmitteln. Sie können die Rangsummen per Formel nachbauen, das ist fehleranfällig. Nutzen Sie dafür JASP (kostenlos), SPSS oder R.
Excel oder SPSS: Was ist besser für die Auswertung?
Excel eignet sich für Dateneingabe, Bereinigung, beschreibende Statistik und einfache Tests. SPSS bietet alle gängigen Verfahren, Voraussetzungstests und eine Syntax, mit der Sie jeden Schritt dokumentieren. Für komplexe Fragestellungen und Fragebogenstudien mit vielen Skalen ist SPSS, JASP oder R die bessere Wahl.
Wie erstelle ich eine Statistik in Excel?
Legen Sie die Daten mit einer Zeile pro Fall an, berechnen Sie Kennwerte mit MITTELWERT, MEDIAN und STABW.S, zählen Sie Häufigkeiten mit ZÄHLENWENN oder einer PivotTable und stellen Sie die Ergebnisse als Histogramm, Boxplot oder Säulendiagramm dar.
Quellen
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2. Aufl.). Lawrence Erlbaum.
- Delacre, M., Lakens, D. & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101.
- American Psychological Association (2020). Publication manual of the American Psychological Association (7. Aufl.).
- Microsoft Support: Laden der Analyse-Funktionen in Excel. https://support.microsoft.com/de-de/office/laden-der-analyse-funktionen-in-excel-6a63e598-cd6d-42e3-9317-6b40ba1a66b4